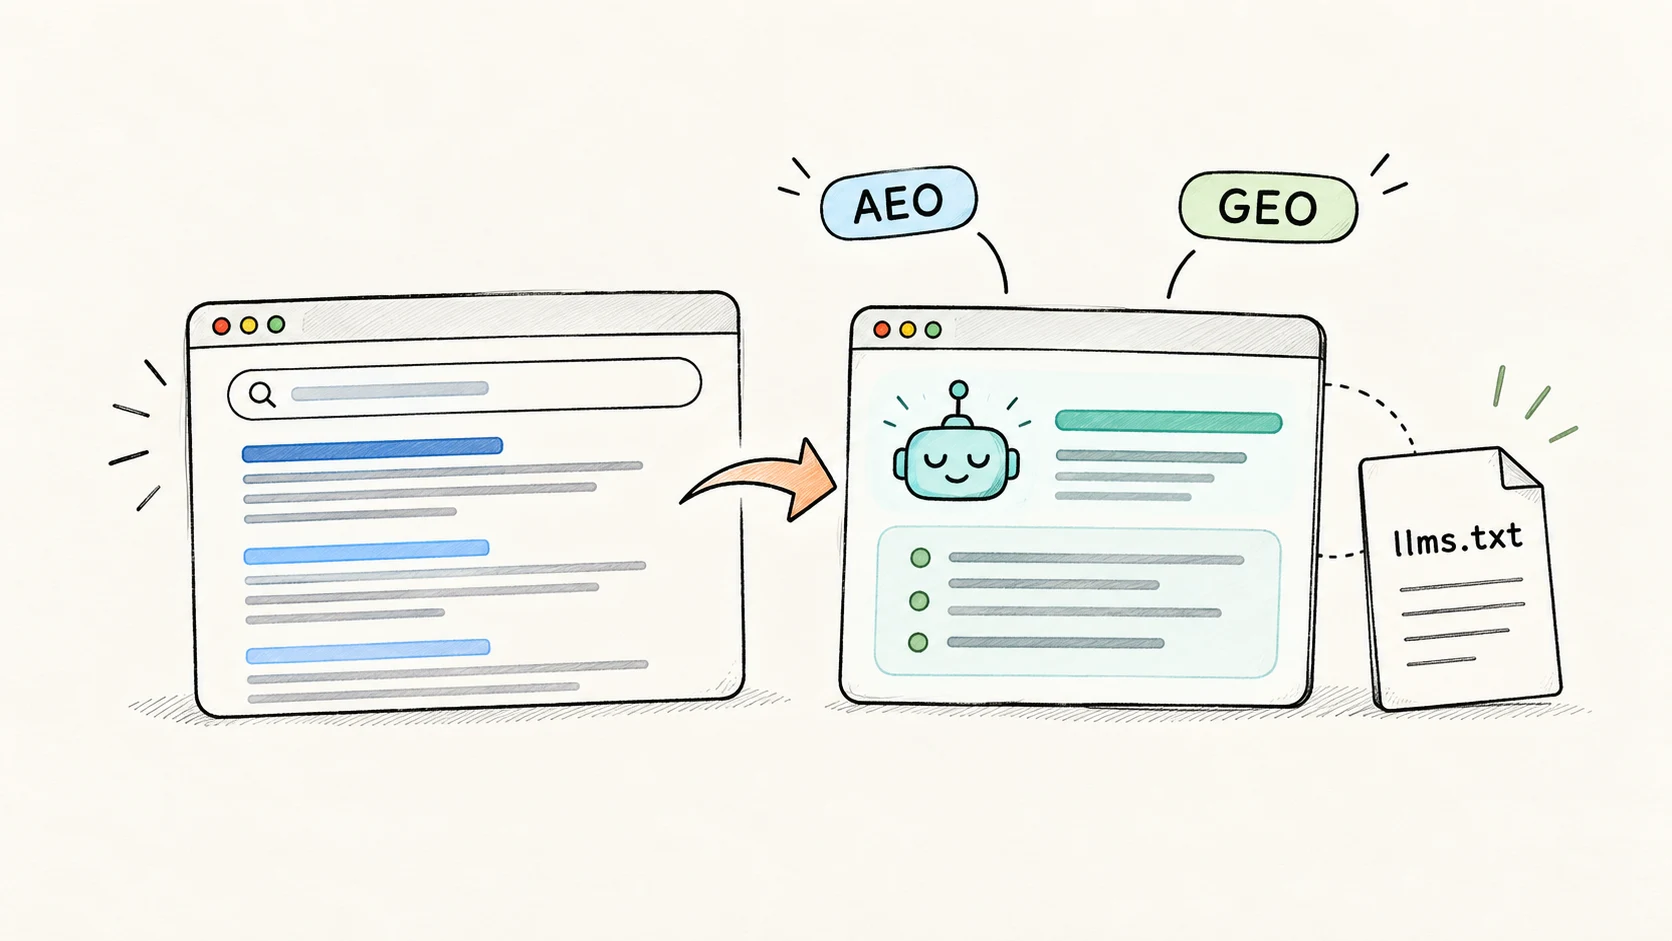
Yapay zekâ SEO’su denince çoğu zaman tamamen yeni bir optimizasyon yöntemi varmış gibi anlaşılıyor. Ben bunu, SEO’nun yerine geçen ayrı bir alan olarak görmüyorum. Kullanıcıların bazı aramalarda bağlantı listesi yerine yapay zekâ tarafından hazırlanmış kısa bir cevap, özet veya kaynak önerisiyle karşılaşması; içeriği daha açık, güncel ve doğrulanabilir hazırlamayı önemli hâle getiriyor.
Bu değişimle birlikte AEO, GEO ve llms.txt gibi terimler daha sık konuşulmaya başladı. İyi SEO’nun temel ilkeleri hâlâ yerinde duruyor: Doğru bilgiyi, anlaşılır bir sayfada, teknik olarak erişilebilir biçimde sunmak. Değişen şey, bu içeriğin sadece klasik arama sonucu için değil, cevap üreten sistemler tarafından da daha rahat anlaşılmasının önem kazanması. Bu rehberde bu üç kavramın nerede ayrıştığını, llms.txt dosyasının ne işe yaradığını ve beklentiyi nerede sınırlamak gerektiğini anlatacağım.
AEO nedir?
AEO (Answer Engine Optimization), Türkçeye cevap motoru optimizasyonu olarak çevrilebilecek bir yaklaşım. Amaç, bir kullanıcının sorusuna doğrudan ve güvenilir cevap verebilen içeriği hazırlamak.
Örneğin bir kullanıcı “SSL nedir?” diye aradığında, sayfanın ilk paragrafında konuyu açıkça tanımlamasını bekler. Tanımı on paragrafa yaymak, sayfayı alakasız bir satış metniyle açmak veya cevabı ancak SSS bölümünde vermek hem okuyucuyu hem de içeriği anlamaya çalışan sistemleri zorlaştırır.
AEO için tek bir resmî kontrol listesi yok. Bunu ayrı bir algoritma hilesi gibi görmek de doğru değil. Pratikte şu soruya odaklanıyor: Sayfayı açan kişi, aradığı sorunun cevabını hızlıca bulabiliyor mu ve bu cevabın neden güvenilir olduğunu anlayabiliyor mu?
GEO nedir?
GEO (Generative Engine Optimization) ise üretken yapay zekâ ile cevap oluşturan arama ve sohbet deneyimlerinde bir markanın veya içeriğin kaynak olabilmesini anlatmak için kullanılan terim. ChatGPT, Gemini ya da benzeri sistemlerin her biri içerikleri aynı şekilde bulmaz, taramaz veya kaynak göstermez. Bu nedenle GEO için herkes için geçerli, sonuç garantisi veren bir tarif vermek mümkün değil.
Yine de GEO’nun işaret ettiği konu anlaşılır: Kullanıcı artık yalnızca bağlantı listesi görmüyor; bazı sorgularda doğrudan sentezlenmiş bir cevap görüyor. İçeriğiniz bu cevabın içinde kaynak olarak yer almasa bile, kullanıcıların sorusunu karşılayan sayfanızın açık, güncel ve kanıtlanabilir olması eskisinden de önemli hâle geliyor.
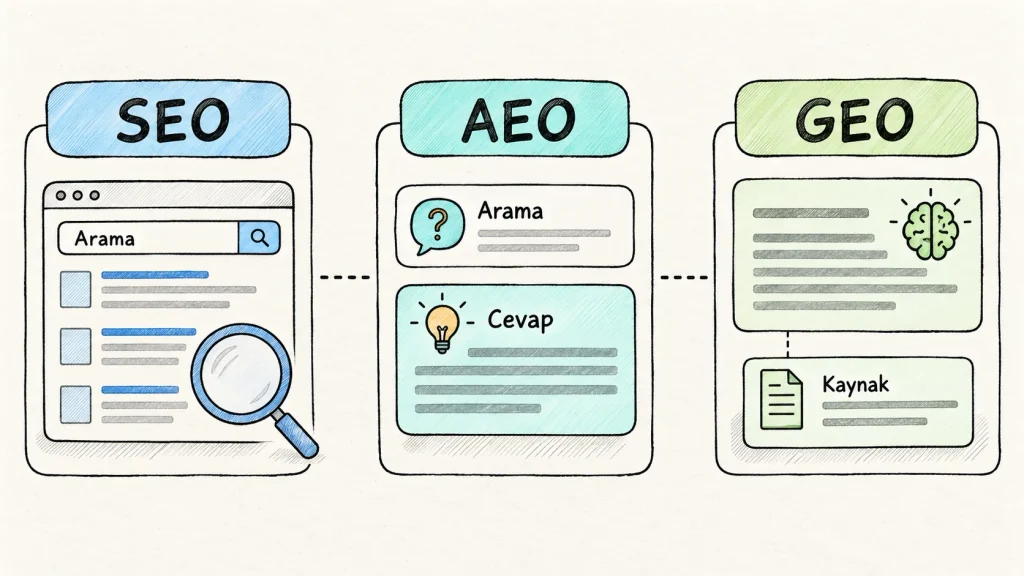
Ben AEO ve GEO’yu birbirinden tamamen kopuk iki çalışma alanı olarak görmüyorum. AEO, soruya iyi cevap veren içerik tarafını; GEO ise bunun üretken yapay zekâ deneyimlerindeki görünürlük boyutunu anlatıyor.
| Kavram | Temel soru | Odak noktası |
|---|---|---|
| SEO | Arama motoru bu sayfayı bulup anlayabiliyor mu? | Tarama, indeksleme, arama niyeti ve kullanıcı deneyimi |
| AEO | Kullanıcı sorusunun cevabını sayfada hemen bulabiliyor mu? | Açık cevap, bağlam ve okunabilir yapı |
| GEO | Üretken cevap sistemleri için güvenilir bir kaynak olabilir mi? | Özgünlük, güncellik, uzmanlık ve erişilebilirlik |
Bu üçü arasında rekabet yok. Sağlam bir SEO temeli olmadan AEO veya GEO için konuşmak biraz çatısı olmayan eve perde seçmeye benziyor.
AEO ve GEO için içerik nasıl hazırlanmalı?
Buradaki amaç, her metni kısa ve yüzeysel cevaplara dönüştürmek değil. Kapsamlı yazılar hâlâ değerli. Fakat okuyucunun konunun neresinde olduğunu anlayabilmesi ve aradığı bölüme ulaşabilmesi gerekiyor.
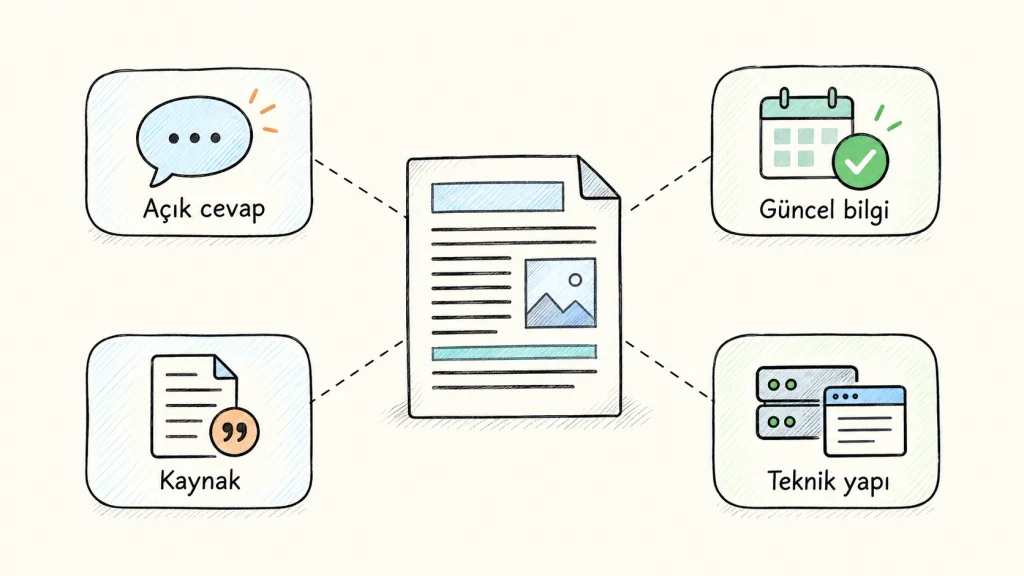
Sorunun cevabını geciktirmeyin
“X nedir?” başlıklı bir içerik, ilk bölümde gerçekten X’in ne olduğunu söylemeli. Sonra nasıl çalıştığını, avantajlarını, sınırlarını ve örneklerini açabilirsiniz. Ben teknik blog yazılarında önce kısa tanımı, hemen ardından da okuyucunun karar vermesini sağlayacak bağlamı vermeyi daha doğru buluyorum.
Bir cümlelik tanım tek başına yeterli olmayabilir; ancak okuru beş ekran kaydırdıktan sonra cevaba ulaştırmak da iyi bir deneyim değil.
Başlıkları gerçek sorular ve alt konular için kullanın
Başlıklar yalnızca metni görsel olarak bölmek için kullanılmamalı. Her başlık, altında kendi başına anlamlı bir soruya veya alt konuya cevap vermeli. “Nasıl çalışır?”, “Kimler için uygundur?”, “Ne zaman kullanılmamalıdır?” gibi başlıklar hem okuma akışını düzenler hem de sayfanın kapsamını netleştirir.
Bu, her başlığı bir anahtar kelime varyasyonuna çevirmek anlamına gelmiyor. Aynı ifadeyi doğal olmayan biçimde tekrar etmek yerine, konuyu gerçekten tamamlayan soruları seçmek daha faydalı.
İlk elden bilgiyi ve sınırları yazın
Yapay zekâ ile üretilmiş yüzlerce benzer metnin olduğu bir ortamda, genel tanımlar tek başına daha az ayırt edici hâle geliyor. Bir hizmeti kullanırken karşılaşılan gerçek bir senaryo, bir teknik seçimin nedeni, güncel dokümantasyona dayanan bir ayrıntı veya istisna durumlar yazıyı değerli kılıyor.
Burada önemli olan, deneyim varmış gibi davranmamak. Bilmediğiniz bir konuda kesin hüküm vermek yerine sınırı söylemek daha güvenilir. Örneğin “bu yapı her projede daha hızlıdır” demek yerine, hangi koşulda avantaj sağlayabileceğini ve neyi tek başına çözmeyeceğini anlatmak gerekir.
Güncelleme ve kaynak bilgisini görünür tutun
Özellikle fiyat, sürüm, güvenlik, mevzuat veya teknik destek kapsamı gibi değişebilen bilgilerde yayın veya güncelleme tarihi önemlidir. Gerekli olduğunda birincil kaynağa bağlantı vermek de okuyucunun bilgiyi kontrol etmesini kolaylaştırır.
Bu yaklaşım yeni değil. İyi içerik zaten bunu yapıyordu. Ancak cevap üreten sistemlerin hatalı veya eski bilgiyi tekrar etme riski düşünüldüğünde, kaynak ve güncellik tarafı daha görünür bir sorumluluk hâline geliyor.
Teknik yapı neden hâlâ önemli?
Bir içeriğin iyi yazılmış olması, her sistemin o içeriğe mutlaka ulaşacağı anlamına gelmez. Sayfanın ziyaretçiye ve tarayıcılara açık olması, doğru HTTP yanıtı vermesi, yanlışlıkla noindex ile işaretlenmemesi, anlamlı iç linkler alması ve mobilde okunabilir olması temel konular.
Site performansını da bu çerçevede değerlendirmek gerekir. Ağır görseller, gereksiz JavaScript veya sunucu kaynaklı gecikmeler, ziyaretçinin cevaba ulaşmasını zorlaştırabilir. Performans tarafında hangi metriklerin izlenebileceğini Core Web Vitals ve Google PageSpeed rehberinde detaylı olarak anlatmıştım.
Yapılandırılmış veri de uygun sayfalarda yardımcı olabilir. Örneğin ürün, makale veya breadcrumb bilgilerini sayfadaki görünen içerikle tutarlı biçimde işaretlemek, sayfanın bağlamını daha açık ifade eder. Ancak yapılandırılmış veri eklemek, bir yapay zekâ aracında ya da arama sonucunda görünme garantisi değildir.
llms.txt nedir?
llms.txt, bir sitenin veya sitenin belirli bir bölümünün yapısını, kısa bir açıklamayla ve seçilmiş Markdown bağlantılarıyla LLM’lere ve ajanlara sunmayı öneren bir dosya biçimi. Dosya genellikle alan adının kökünde https://siteadi.com/llms.txt adresinde bulunur.
Bu fikrin çıkış noktası basit: Web sayfaları insanlar için hazırlanıyor; menüler, bileşenler, reklam alanları ve JavaScript nedeniyle bir ajanın asıl bilgiye ulaşması her zaman kolay olmuyor. Küçük bir yönlendirme dosyası, önemli sayfaları ve mümkünse bu sayfaların temiz Markdown sürümlerini işaret edebilir.
llms.txt için önerilen biçim; sitenin adıyla başlayan bir başlık, kısa açıklama ve konu başlıklarına göre gruplanmış bağlantılardan oluşuyor. Ayrıntılı biçim önerisine llmstxt.org üzerinden ulaşabilirsiniz.
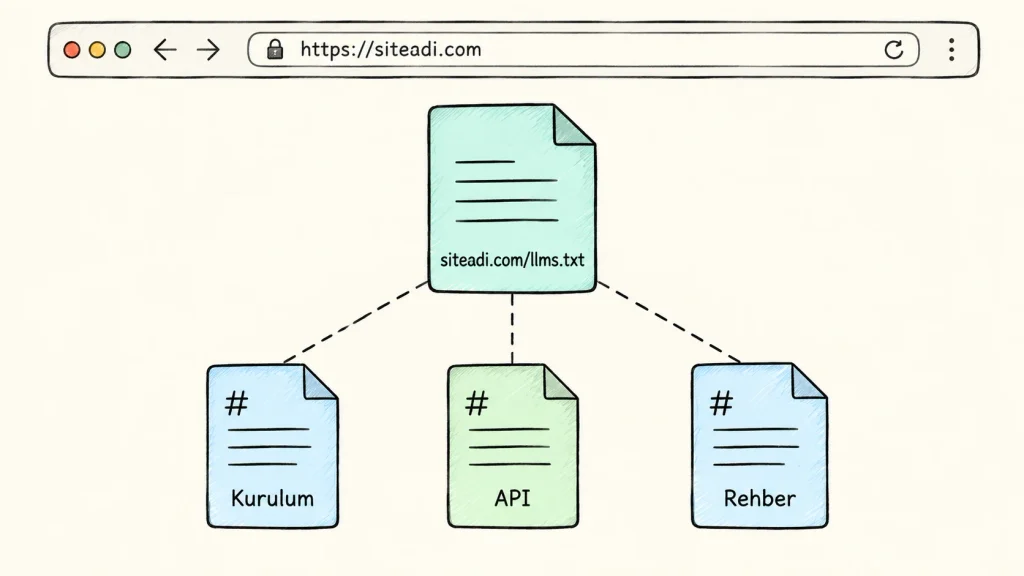
Basit bir örnek şu şekilde görünebilir:
# Örnek Yazılım Dokümantasyonu

> Ürünün kurulumu, API kullanımı ve sürüm notları.

## Başlangıç

- [Kurulum](https://siteadi.com/docs/kurulum.md): İlk kurulum adımları
- [Hızlı Başlangıç](https://siteadi.com/docs/hizli-baslangic.md)

## Referans

- [API Dokümantasyonu](https://siteadi.com/docs/api.md)
llms.txt ne yapmaz?
Burada beklentiyi doğru kurmak gerekiyor. llms.txt henüz zorunlu veya evrensel kabul edilmiş bir web standardı değil; bir öneri. Bir dosya eklemek, sitenizin tüm yapay zekâ araçları tarafından taranacağı, cevaplarda kaynak gösterileceği veya daha üstte görüneceği anlamına gelmez.
Ayrıca robots.txt, XML site haritası, doğru başlık yapısı, yapılandırılmış veri ve özgün içerik yerine geçmez. Bunların her biri farklı iş görür. robots.txt tarama tercihleriyle, site haritası önemli URL’lerin bildirilmesiyle, llms.txt ise seçilmiş içeriklere bağlam sunma fikriyle ilgilidir.
Gizli kalması gereken bilgi, yönetim paneli URL’leri veya herkese açık olmayan dokümanlar da bu dosyaya eklenmemeli. llms.txt bir erişim kontrolü katmanı değildir.
Her web sitesinin llms.txt dosyasına ihtiyacı var mı?
Kapsamlı teknik dokümantasyon, yardım merkezi, API referansı veya çok sayıda ürün dokümanı bulunan sitelerde llms.txt daha anlamlı olabilir. Çünkü geniş içerik arşivinde ajana başlangıç noktası ve güvenilir sayfa listesi sunar.
Küçük bir kurumsal sitede ise önce sayfaların gerçekten güncel, erişilebilir ve anlaşılır olduğundan emin olmak daha yüksek öncelik. Birkaç sayfalık dağınık veya eski içeriğin yanına llms.txt eklemek, temel problemi çözmez.
Ben olsam uygulama sırasını şöyle kurarım:
- Aranan sorulara cevap veren, güncel ve özgün sayfaları hazırlarım.
- Sayfaların teknik erişilebilirliğini, iç linklerini ve mobil deneyimini kontrol ederim.
- Sık sorulan ve karar vermeyi etkileyen bilgileri açık başlıklarla düzenlerim.
- Geniş ve düzenli bir dokümantasyon yapısı varsa,
llms.txtile önemli kaynaklara yönlendirme eklerim. - Sonucu varsaymak yerine, organik görünürlük, gelen ziyaretçi ve kullanıcı geri bildirimi üzerinden takip ederim.
Yapay zekâ için değil, belirsizliği azaltmak için yazın
AEO ve GEO konuşulurken en kolay hata, her şeyi yapay zekânın beğeneceği cümlelere dönüştürmek. Oysa iyi bir teknik içerik; okuyucunun sorusunu, ihtiyacını ve karar anını merkeze almalı. İnsan için anlaşılır olmayan bir sayfanın uzun vadede makine için de sağlıklı bir kaynak olmasını beklemek mantıklı değil.
Bu yüzden AEO’yu, GEO’yu veya llms.txt dosyasını bağımsız birer büyüme taktiği olarak görmüyorum. Bunlar; düzgün bir içerik arşivi, sağlam teknik altyapı ve açık iletişimin üzerine eklenebilecek katmanlar.
Arama deneyimi değişiyor, buna şüphe yok. Fakat temel soru değişmiyor: Kullanıcı sitenize geldiğinde gerçekten işine yarayan, doğrulayabileceği bir cevap buluyor mu? Buna odaklanan siteler, hangi arayüz öne çıkarsa çıksın daha sağlam bir yerde duruyor.